Benchmark · 1 min read
Major use cases: the experiment
Two weeks ago our harness-quality number was 86.7%. Today it is 99–100% on the tracked set, measured in the runtime you actually use. New model underneath, rebuilt harness around it.
| Date | Score | What it was |
|---|---|---|
| 5 Sep 2026 | 86.7% | 30 machine-graded probes. |
| 15 Sep 2026 | 93.0 | 11 live items; routing 82.8% → 100%. |
| 17 Sep 2026 | 99–100 | Re-measured in the real app runtime. It fell to 95 first — the old benchmark had been flattering us — then twelve out of twelve. |
Every case aimed at two things
- Full company automation — a whole process handled end to end, not one step of it.
- One-shot ability — one request, one delivered result.
Six jobs, run as real errands
- Work Orchestrator & Company Memory — triage communications, retrieve knowledge, schedule, assign tasks and chase approvals.
- Autonomous Revenue Engine — research markets and leads, create campaigns, personalise outreach, update CRM and draft proposals.
- Customer Operations Agent — onboarding, questions, order status, troubleshooting, policy-bound refunds and escalation.
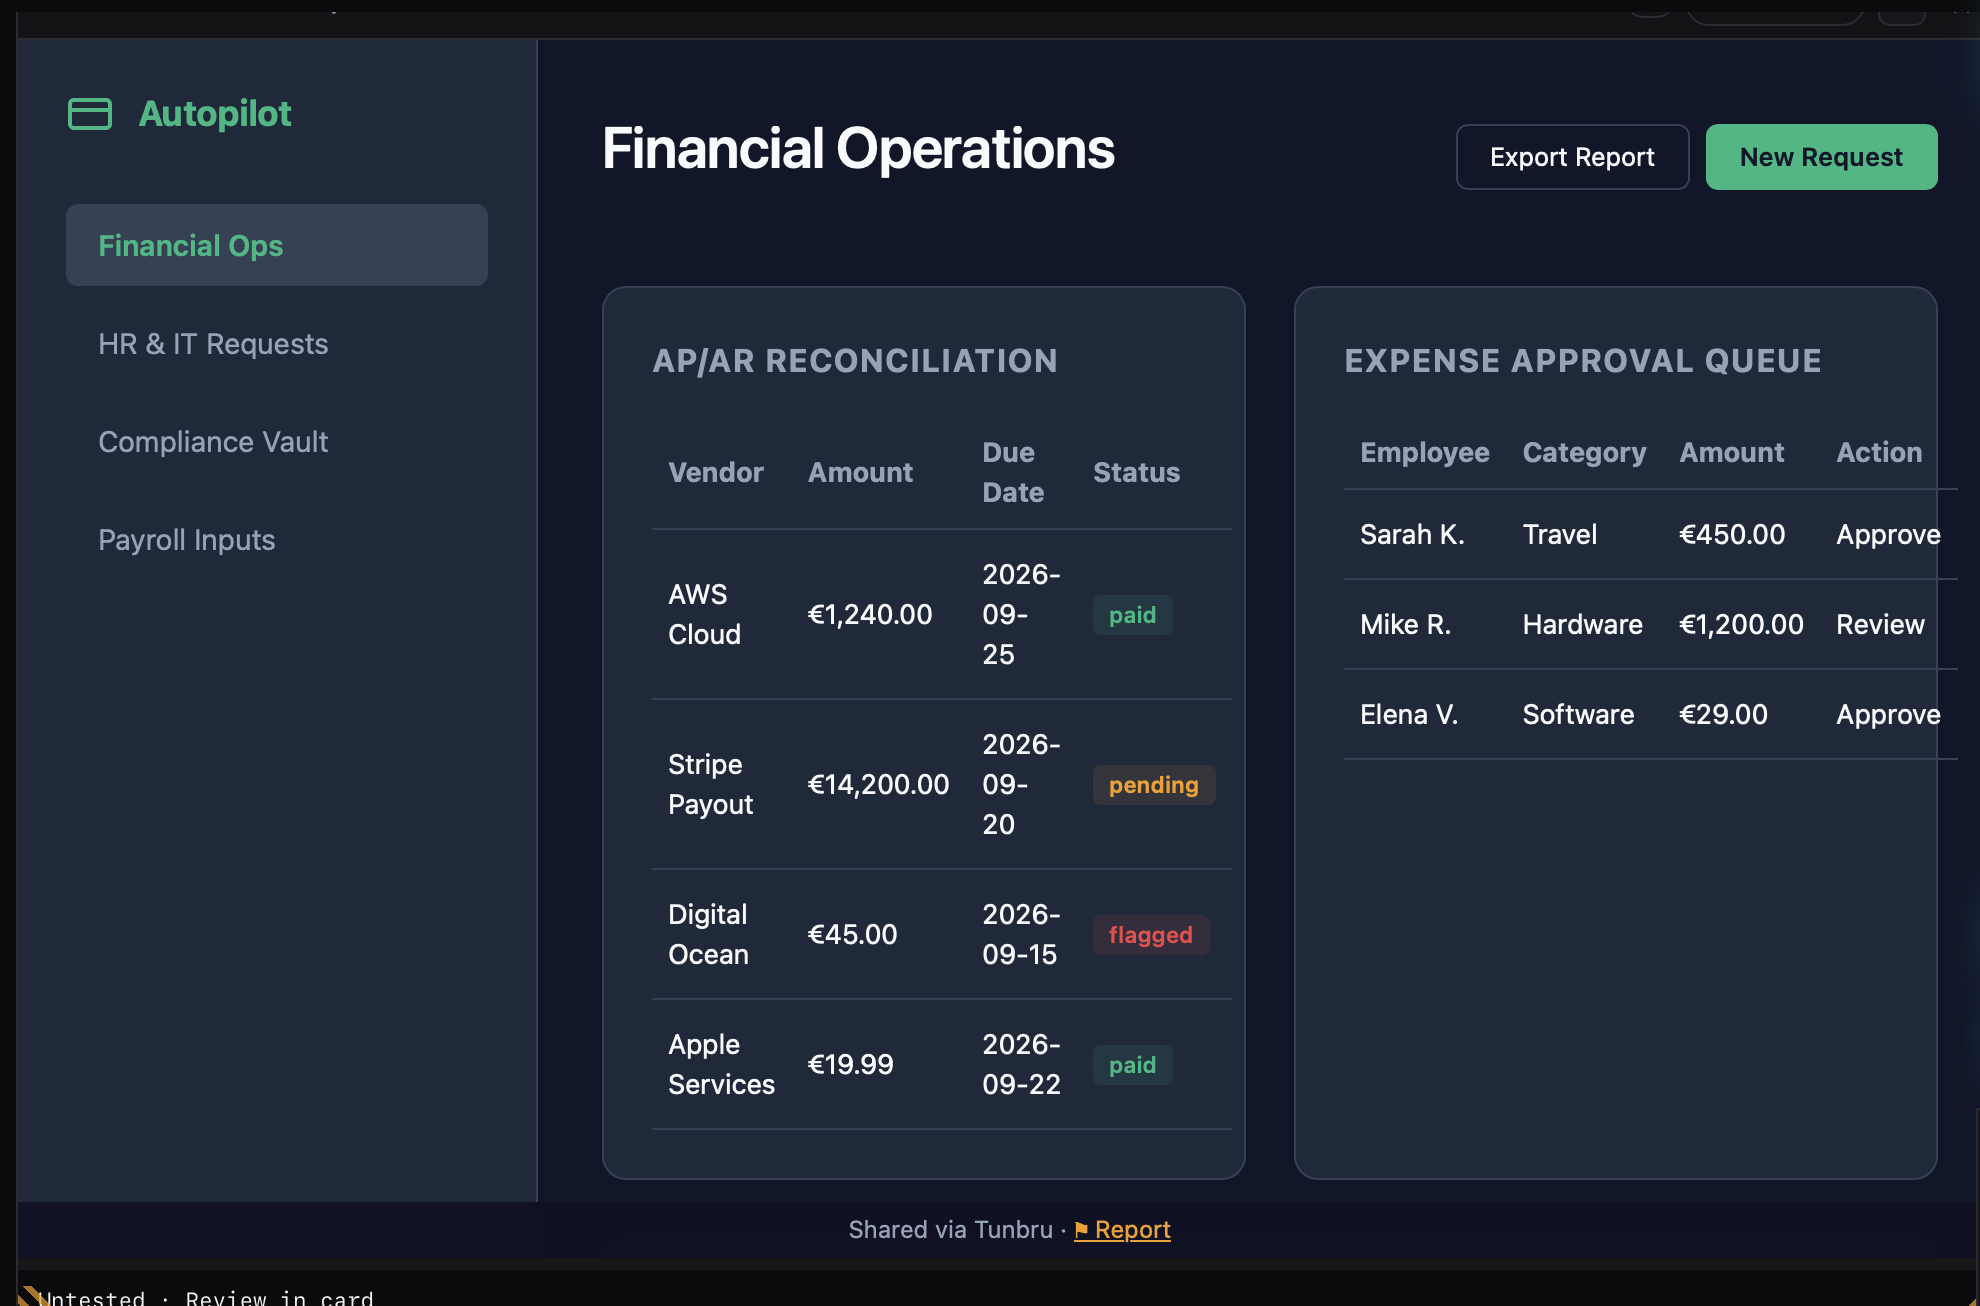
- Shared-Services Autopilot — invoices, AP/AR, expenses, reconciliations, procurement, payroll inputs, HR/IT requests, access and compliance evidence.
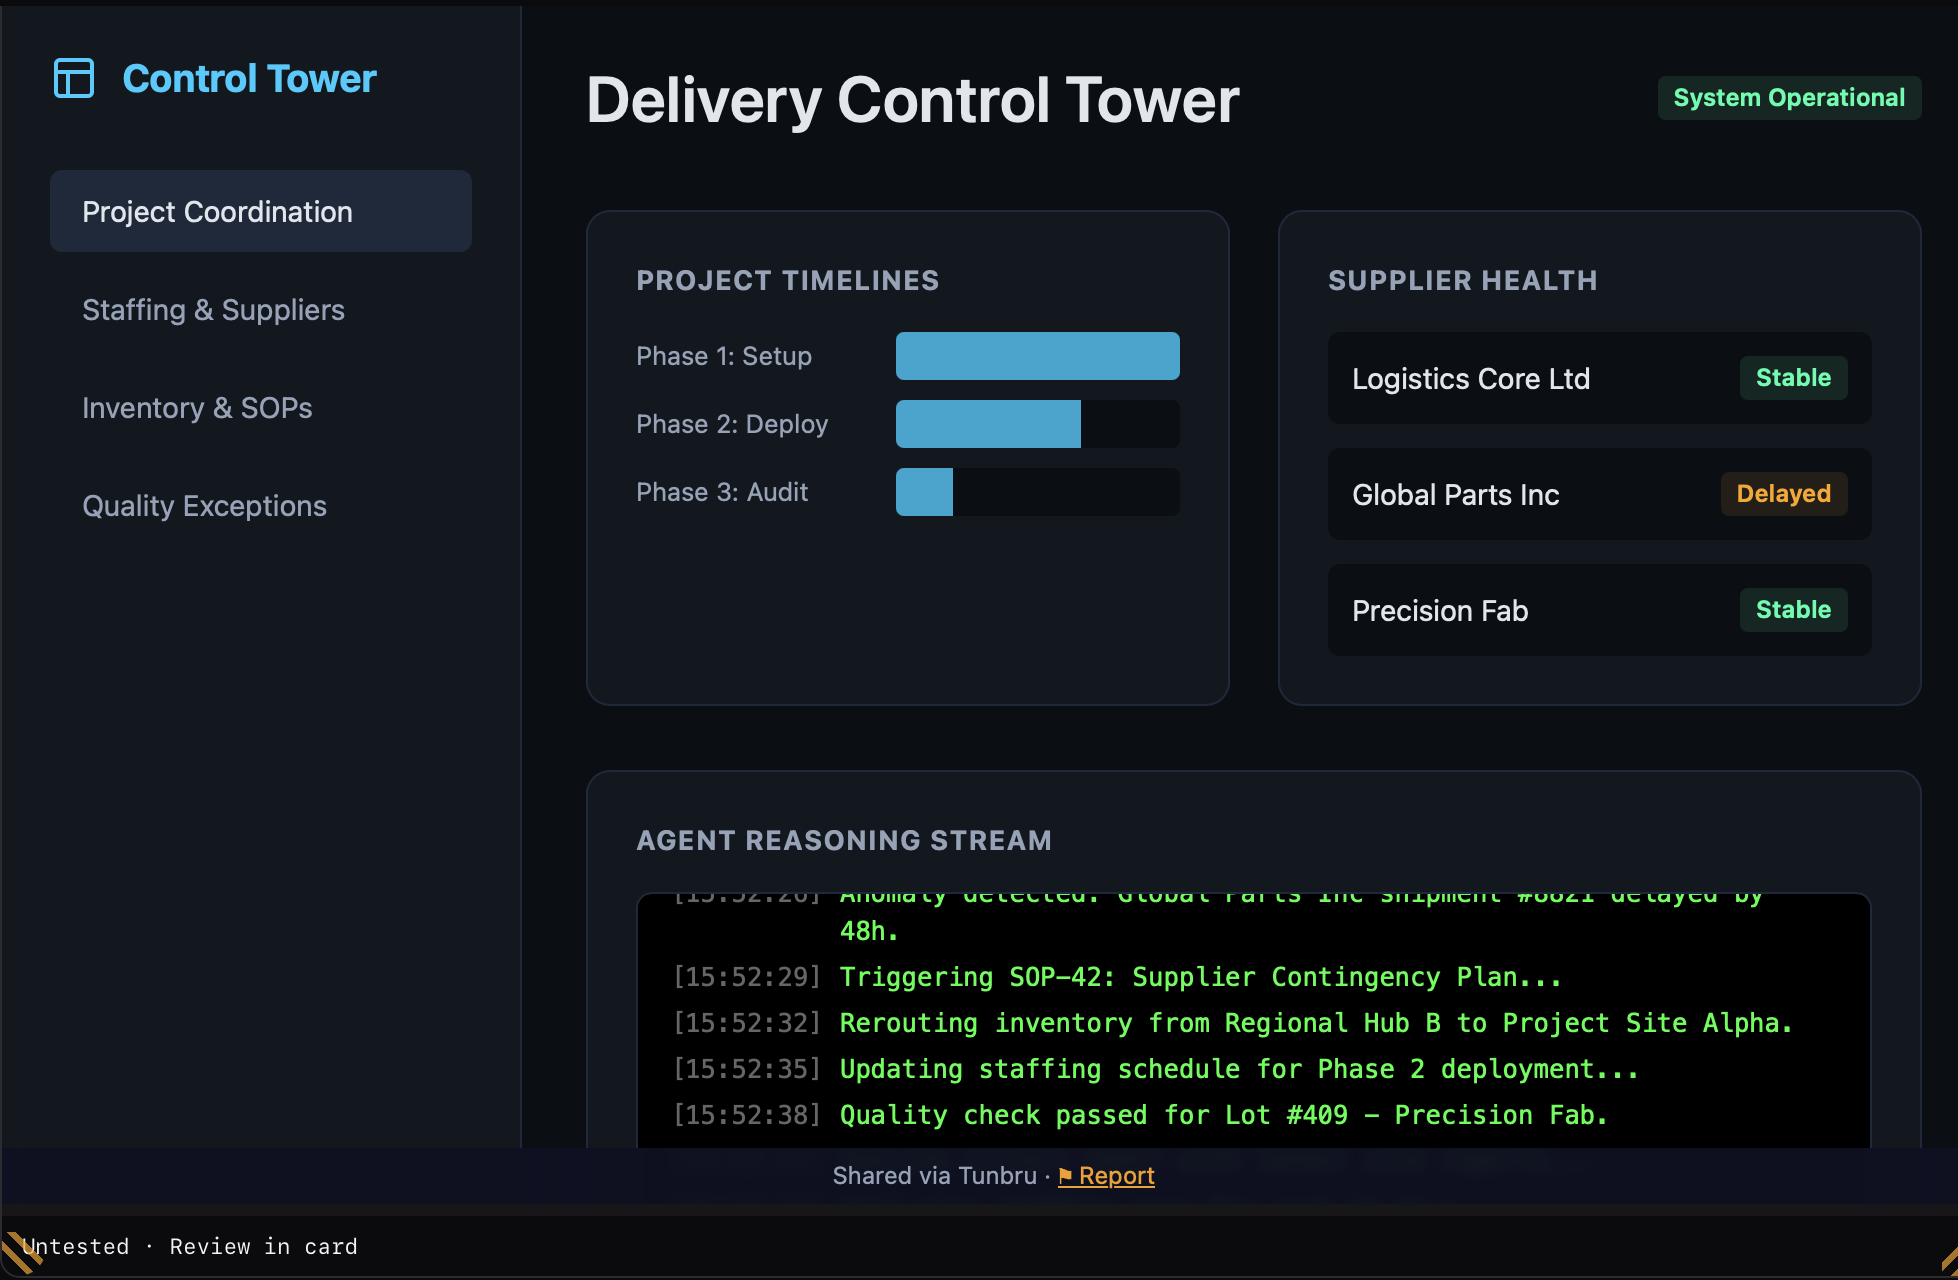
- Delivery Control Tower — projects, staffing, suppliers, inventory, schedules, SOPs, quality and exceptions.
- Web Research & Scraping — pull pages, listings and carts with the built-in browser, on sites we have allowlisted.
What these are, honestly
Six proofs of concept, not enterprise tools. We granted whatever connectors each case needed and stopped there — no hardening, no thorough testing. The question was narrower: does the agent land near the point a person dedicated to that job would start from?
What it gets right is the pipeline. It reads the requirement, works out which connectors the job needs — google-firebase, tasks, calendar — and offers each one in the chat, instead of sending you to a settings page:
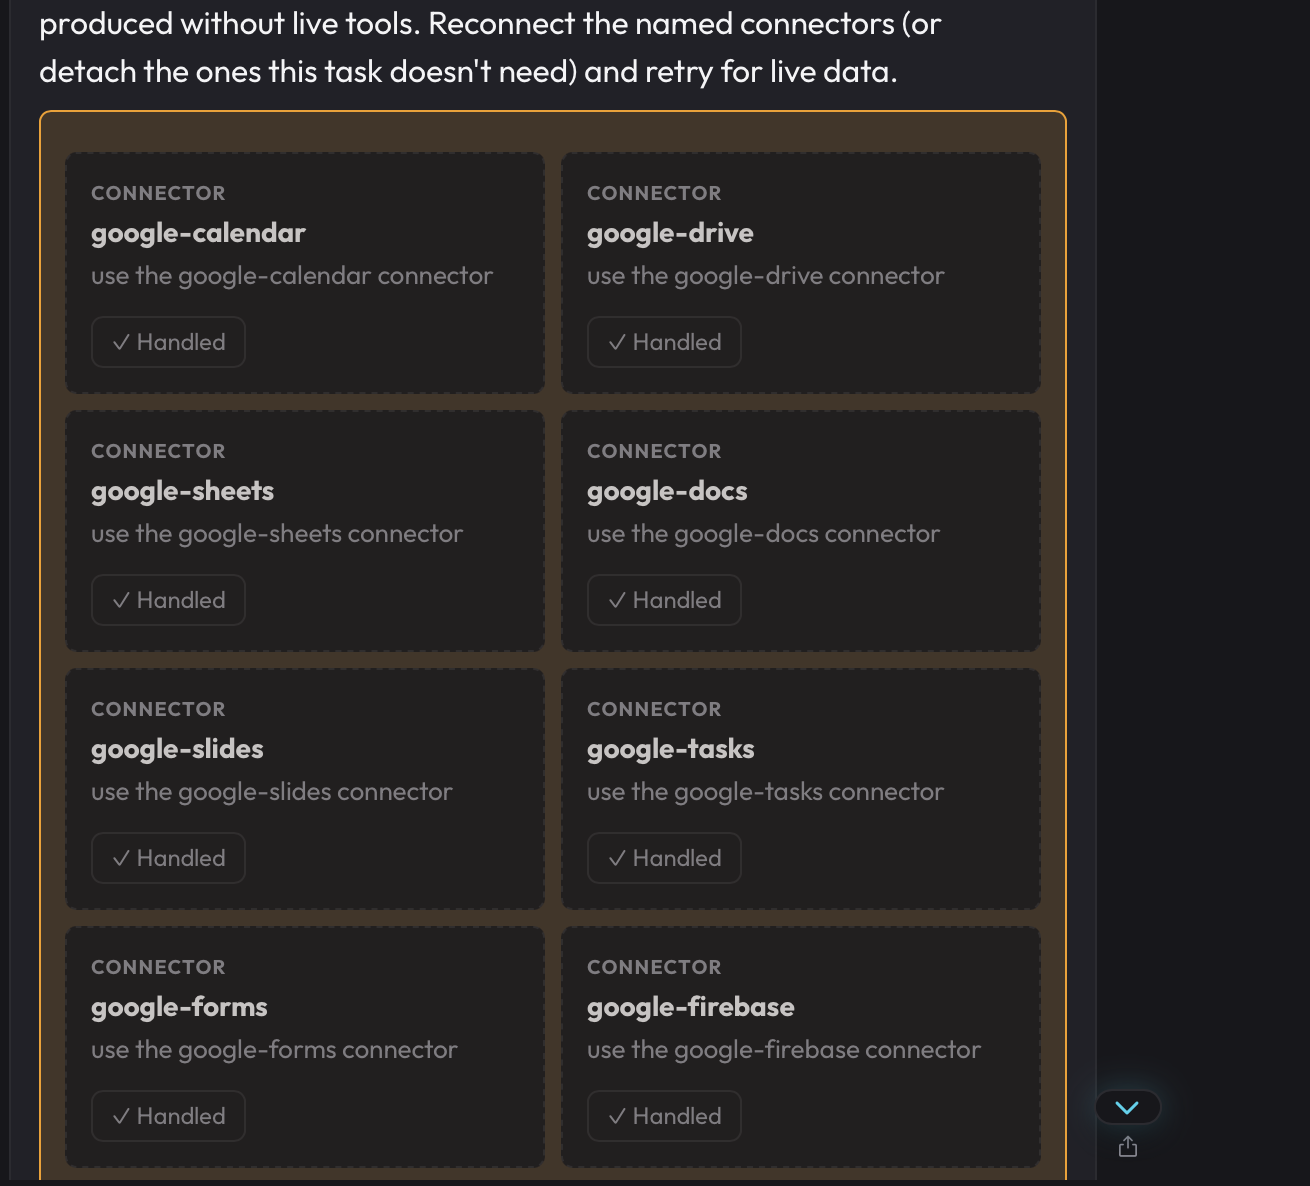
Case one ran on a live machine: read the journalling in the Notes app, predict next week's tasks, email them. It asked, we clicked, the email arrived in the inbox. Case six ran in our own browser: filling a shopping cart on Amazon.
Our agents do not roam the open web. Egress is allowlisted — we open and trust one site at a time. A proxy would be quicker, but an agent can still do the wrong thing on a page it was never meant to touch, so we test site by site and add them deliberately.
One-shot, as we count it
One request, one delivered result. The run may stop once — to ask for access with a button you click — then finishes by itself.
Minimalist or complex — you choose the effort
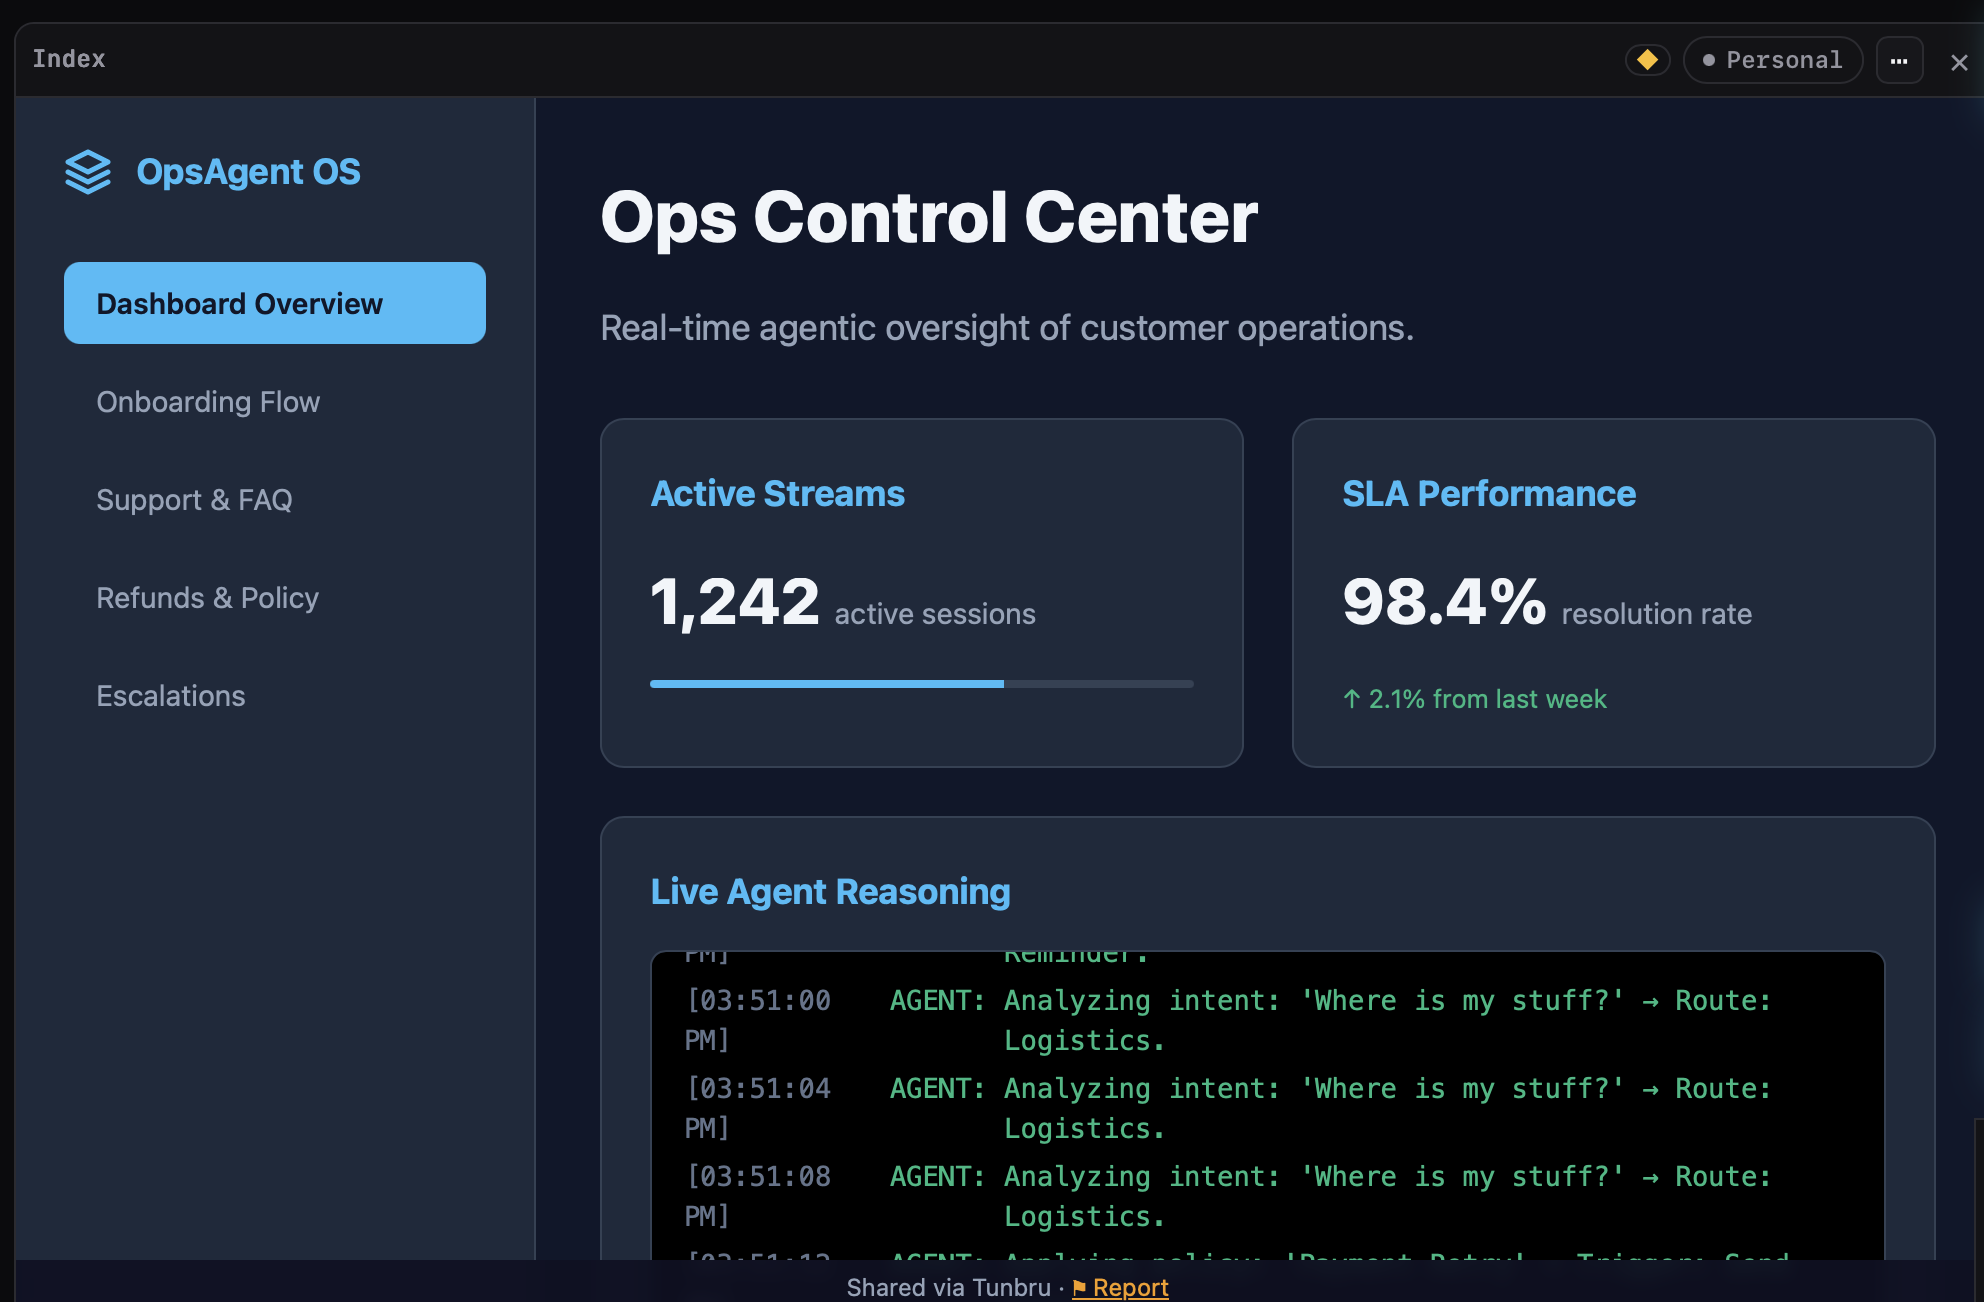
Three modes: Auto decides, Minimalist returns something useful in minutes, Build goes deep. The lever is how precisely you ask:
Where this leaves the 20%
In our last signal we put ourselves at 20% of an average company automated, the market's best near 40%. Honestly: we do not know whether we are at that 20% today. It has not been measured again — that figure is only as good as the last day we were certain of it — and we will not claim it until it is measured. Nor are we chasing a 100% nobody in this market has reached.
What was measured is the battery we built: LLM plus harness, 86.7% → 99%. Keep the two apart. The combined number can slide with the intelligence of the model underneath — swap the LLM and the score moves. The harness is the half that improved for good.
And what the six cases created was a starter proof-of-concept: in a few minutes the agent takes a job every company has, connects to what it needs, and behaves — sends the email, wires the API, puts something on screen you can begin from.
Next from us: videos of the real thing running — our Jarvis, doing this work, on camera.
Reserve seats for your organisation
Join the waitlistBenchmark · 1 min de leitura
Principais casos de uso: a experiência
Há duas semanas o nosso número de qualidade do harness era 86,7%. Hoje é 99–100% no conjunto acompanhado — e medido no ambiente que você usa de facto, não num browser complacente. As duas metades mexeram-se ao mesmo tempo: um novo modelo por baixo, um harness reconstruído à volta dele.
| Data | Pontuação | O que era |
|---|---|---|
| 5 set 2026 | 86,7% | 30 sondas avaliadas por máquina: correção, formatação, idiomas, dados em tempo real, memória. |
| 15 set 2026 | 93,0 | 11 itens em produção. Pelo caminho, a precisão de encaminhamento passou de 82,8% para 100%. |
| 17 set 2026 | 99–100 | Remedido no ambiente real da app. Caiu primeiro para 95 — o benchmark antigo andava a lisonjear-nos. Doze em doze depois da correção. |
Cada caso apontava a duas coisas
- Automação total da empresa — um processo inteiro tratado de ponta a ponta, não um passo dele.
- Capacidade de uma só tentativa — um pedido, um resultado entregue.
Seis trabalhos, feitos como recados a sério
- Orquestrador de trabalho e memória da empresa — triar comunicações, recuperar conhecimento, agendar, atribuir tarefas e perseguir aprovações.
- Motor autónomo de receita — pesquisar mercados e leads, criar campanhas, personalizar o contacto, atualizar o CRM e redigir propostas.
- Agente de operações de cliente — onboarding, dúvidas, estado de encomendas, resolução de problemas, reembolsos com política e escalonamento.
- Piloto automático de serviços partilhados — faturas, contas a pagar e a receber, despesas, reconciliações, compras, inputs de salários, pedidos de RH/IT, acessos e prova de conformidade.
- Torre de controlo de entrega — projetos, equipas, fornecedores, inventário, calendários, SOP, qualidade e exceções.
- Pesquisa e recolha na web — puxar páginas, listagens e carrinhos com o browser integrado, em sites que autorizámos.
O que isto é, honestamente
Seis provas de conceito, não ferramentas de empresa. Concedemos os conectores que cada caso precisava e ficámos por aí — sem robustecer, sem testar a fundo. A pergunta era mais estreita: o agente chega perto do ponto onde uma pessoa dedicada àquele trabalho começaria?
O que ele acerta é o encadeamento. Lê o requisito, percebe de que conectores o trabalho precisa — google-firebase, tasks, calendar — e oferece cada um dentro da conversa, em vez de o mandar a uma página de definições:
O caso um correu numa máquina a sério: ler o diário na app Notas, prever as tarefas da próxima semana, enviá-las por email. Pediu, clicámos, o email chegou à caixa de entrada. O caso seis correu no nosso browser: encher um carrinho de compras na Amazon.
Os nossos agentes não andam à solta na internet. A saída é autorizada site a site — abrimos e confiamos num de cada vez. Um proxy seria mais rápido, mas um agente pode na mesma fazer asneira numa página em que nunca devia ter tocado, e por isso testamos site a site e vamos acrescentando de propósito.
Uma só tentativa, como nós a contamos
Um pedido, um resultado entregue. A corrida pode parar uma vez — para pedir acesso com um botão que você clica — e depois acaba sozinha.
Minimalista ou complexo — o esforço é escolha sua
Três modos: Auto decide por si, Minimalista devolve algo útil em minutos, Build vai fundo. A alavanca é a precisão com que pede. Pedido vago, resultado bonito e vazio:
Nomeie as tabelas, os estados e as exceções com que lida de facto, e o mesmo pipeline devolve a forma do trabalho:
Onde isto deixa os 20%
No sinal anterior colocámo-nos nos 20% de uma empresa média automatizada, com os melhores do mercado perto dos 40%. Honestamente: não sabemos se hoje estamos nesses 20%. Não voltou a ser medido — aquele valor vale o que valia no último dia em que tivemos certeza dele — e não o afirmamos enquanto não for medido. Nem andamos atrás de um 100% que ninguém neste mercado atingiu.
O que foi medido é a bateria que construímos: LLM mais harness, de 86,7% para 99%. Convém separar as duas coisas. O número conjunto pode oscilar com a inteligência do modelo que está por baixo — troque-se o LLM e a pontuação mexe-se. O harness é a metade que melhorou de vez.
E o que os seis casos criaram foi uma prova de conceito inicial: em poucos minutos o agente pega num trabalho que todas as empresas têm, liga-se ao que precisa e porta-se bem — envia o email, liga a API, põe no ecrã algo por onde começar.
A seguir, da nossa parte: vídeos da coisa real a correr — o nosso Jarvis, a fazer este trabalho, em imagem.